Blog & Actualités

Insights & Actualités Tech

Découvrez nos derniers articles sur le développement web, le design et les technologies digitales qui façonnent l'avenir

Recherche pour : "Qwen"
Effacer les filtres
oMLX – Faites tourner vos agents IA en local sur votre Mac

oMLX – Faites tourner vos agents IA en local sur votre Mac

Faire tourner un modèle en local sur un Mac, c'est réglé depuis un moment. Ce qui l'est moins par contre, c'est de brancher un agent de code dessus, parce qu'à chaque reprise de session, le serveur doit malheureusement remouliner des dizaines de milliers de tokens de contexte avant de sortir le...
Nvidia CMP 170HX - La VRAM était bien là, bridée par le firmware

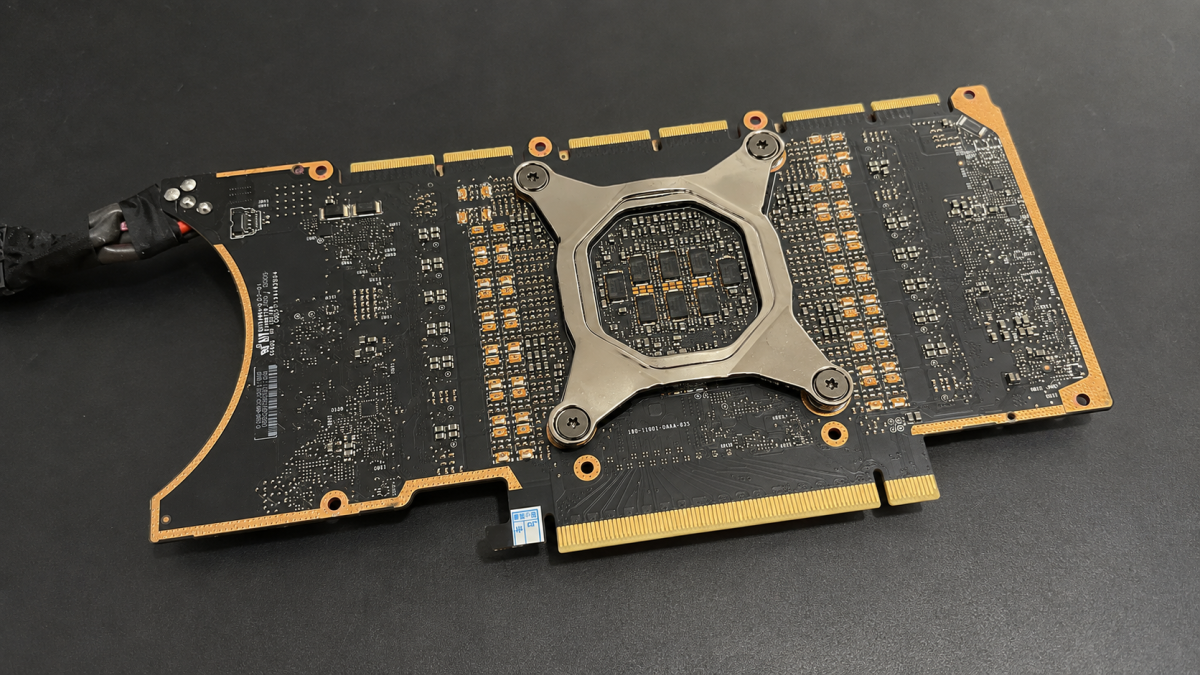
Nvidia CMP 170HX - La VRAM était bien là, bridée par le firmware

Je viens d'apprendre qu'une carte Nvidia normalement dédiée au minage de cryptomonnaies, vendue avec 8 Go de mémoire en expose aujourd'hui 64 Go, sans que rien n'ait été remplacé ou soudé dessus... C'est ça la magie de Nvidia, la mémoire était bien là depuis le début, mais était juste maintenue en...

These startups are chasing the next big thing in LLMs

These startups are chasing the next big thing in LLMs

MIT Technology Review’s What’s Next series looks across industries, trends, and technologies to give you a first look at the future. You can read the rest of them here. Way back in the summer of 2017, AI researchers at Google put out a paper called “Attention Is All You Need,” in which they...

Alibaba annonce Qwen3.8-Max

Alibaba annonce Qwen3.8-Max

Alibaba annonce son nouveau LLM : Qwen3.8-Max. Doté de 2 400 milliards de paramètres et d'une fenêtre de contexte pouvant atteindre 1 million de tokens, Qwen3.8-Max se classe cinquième sur Text Arena et deuxième sur Vision Arena. Il se distingue également par ses performances en programmation, dans...

The Download: Montana’s new experimental drug rules

The Download: Montana’s new experimental drug rules

This is today’s edition of The Download, our weekday newsletter that provides a daily dose of what’s going on in the world of technology. Montana’s plan to become an experimental medical hub just pushed forward  As of this week in Montana, biotech companies whose drugs have been through...

GLM 5.2 censure moins s'il se croit américain

GLM 5.2 censure moins s'il se croit américain

Saviez-vous que ce bon vieux GLM 5.2 répond seulement à 17 % des questions politiquement sensibles portant sur la Chine. Eh bien maintenant, dites-lui qu'il est Claude, et il montera à 85 % !! C'est le résultat que viennent de sortir Benji Berczi et Kyuhee Kim , deux chercheurs du programme MATS,...

Rapid-MLX - Installer un serveur IA local sur votre Mac

Rapid-MLX - Installer un serveur IA local sur votre Mac

Si vous avez un Mac Apple Silicon et que vous en avez assez de payer des tokens à chaque requête, Rapid-MLX vaut le détour. C'est un moteur d'inférence local maintenu par Raullen Chai, qui tape directement dans les kernels MLX d'Apple, sans repli sur llama.cpp ni couche Metal intermédiaire. Et si...

Subwave - La radio maison qui réveille vos MP3 oubliés

Subwave - La radio maison qui réveille vos MP3 oubliés

Si vous avez un Navidrome qui tourne dans un coin et un serveur Ollama qui passe ses journées à ne rien faire, vous ne vous êtes jamais dit que les deux pourraient bosser ensemble ? C'est en tout cas ce qu'a flairé Parminder Klair qui a branché l'un sur l'autre et en a sorti une vraie station de...

Odysseus - L'IA auto-hébergée de PewDiePie enfin rapide sur Mac

Odysseus - L'IA auto-hébergée de PewDiePie enfin rapide sur Mac

Odysseus, c'est le workspace IA que PewDiePie a balancé sur GitHub fin mai. Chat, agents, recherche web, email, calendrier, notes et documents, tout est réuni dans un superbe cockpit auto-hébergé dans lequel les modèles et l'historique peuvent rester sur VOTRE machine. Vous avez aussi un éditeur...

Mage-Flow - Le modèle de diffusion de Microsoft qui tourne sur Mac

Mage-Flow - Le modèle de diffusion de Microsoft qui tourne sur Mac

Microsoft vient de publier Mage-Flow, un modèle de génération d'images de 4 milliards de paramètres, et dont l'objectif est d'atteindre la qualité des gros modèles sans en avoir la taille. Là où FLUX.2 embarque 32 milliards de paramètres, Qwen-Image 20 et Z-Image 6, Mage-Flow joue dans la même cour...